iscc密码安全赛后记
1.哈希长度扩展攻击
题目
某系统采用以下方式对用户请求进行签名:token = sha1(secret_key + user_data)secret_key 为服务端持有的密钥,长度 12 字节。role=admin的签名认证数据,服务器ip地址为:172.16.8.6
以管理员身份登录并获取 FLAG(15 位数字)。POST /auth,参数 user_data 与 token。
接口调用参考代码如下:(给了两条交互路径,第二条是要你本地转hex提交后服务端转回)
系统对外泄露了一个普通用户的凭证:user_data = user=normal&role=normal token = 22ad8989b1b3d9a14e439e9e67f754be3f2c2a00admin用户获取的flag值是什么?(210/分)
分析
这个题目整体还是比较顺利的,辨认出题型
用存的板子(hlextend/hlextend.py at master · stephenbradshaw/hlextend )一下子就出来了
就是利用Merkle–Damgård结构问题原始消息后面追加一段消息
比较坑的就是要注意服务器的解码逻辑,你直接发送m = b'\x00\x12'
会被服务的解码成 10 个 ASCII 字符:b, ', \, x, 0, 0, \, x, 1, 2, ',死活过不了。
所以需要使用另外一条交互路径:本地转16进制再交给服务端转回字节
2.tls
题目
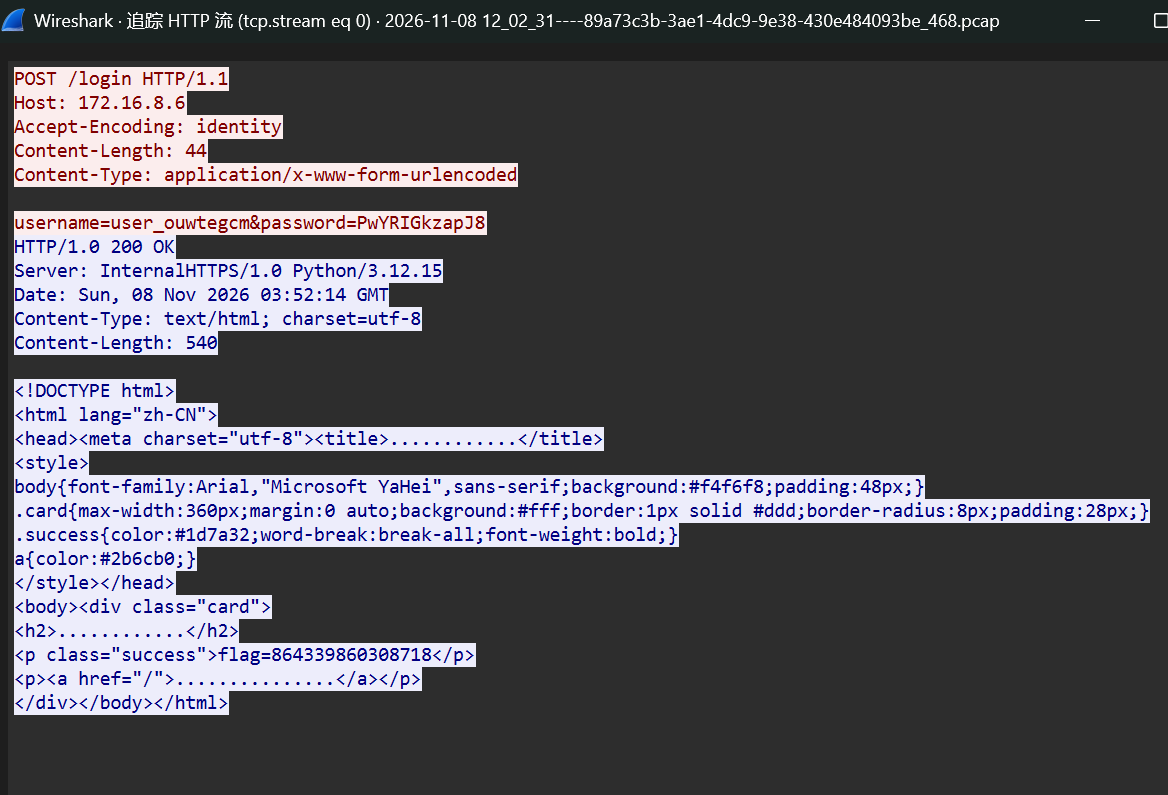
给了一个pem文件和流量包,要求解出tls流量里面的登录的账户密码
分析
这个题目其实跟密码学关系不大,考察wireshark工具等使用
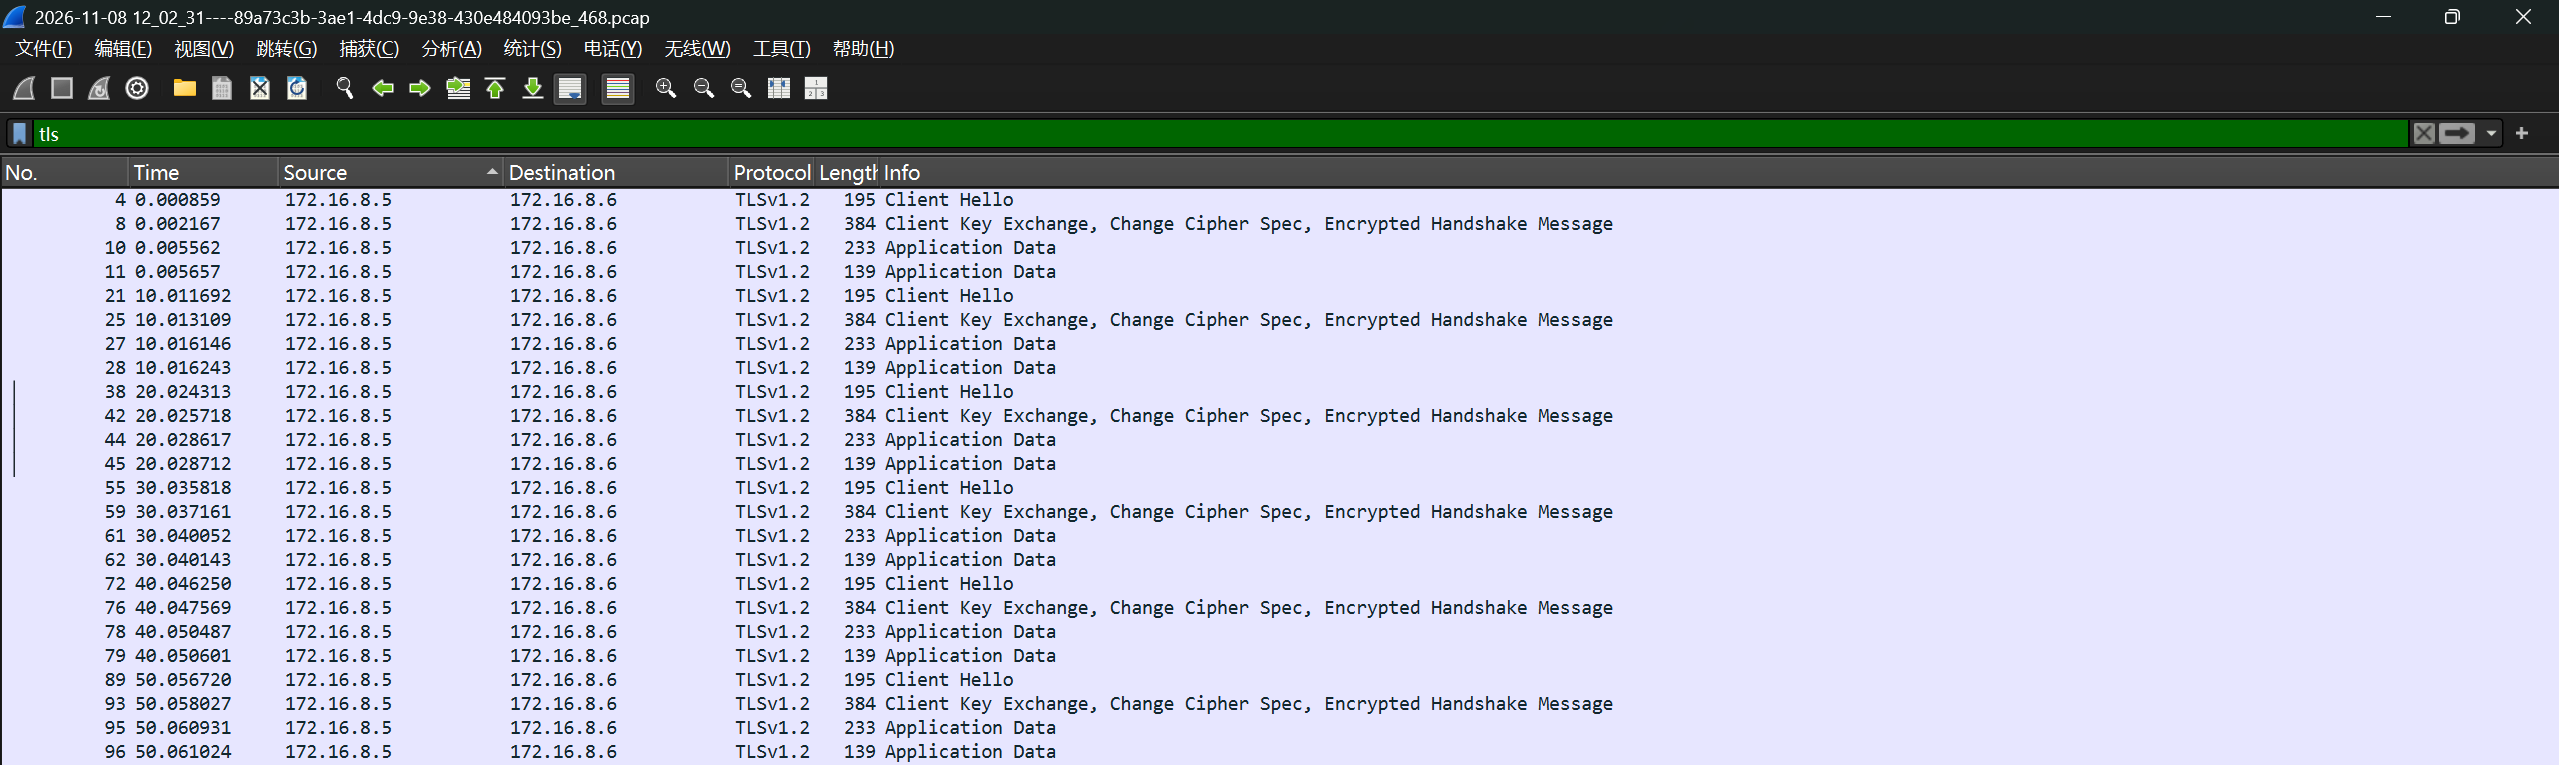
其实流量包长得非常板正,也没什么噪音,就是tls里面client hello那一套
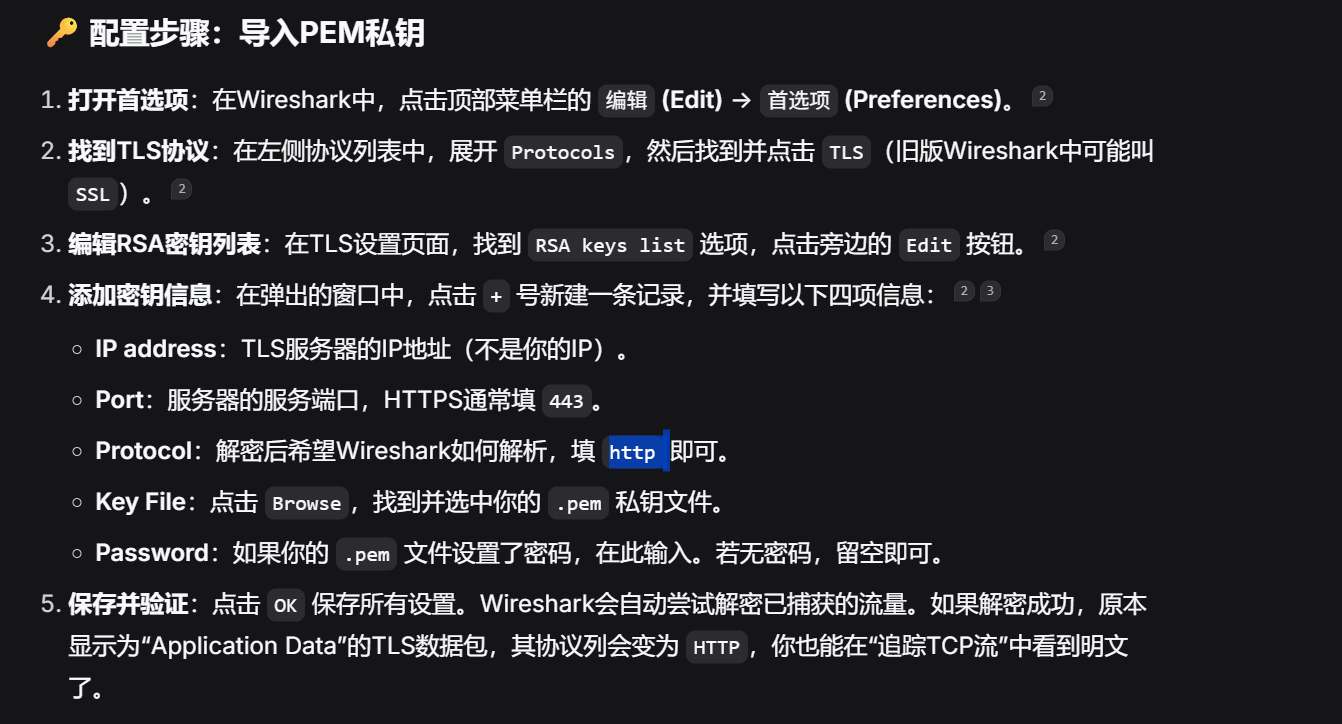
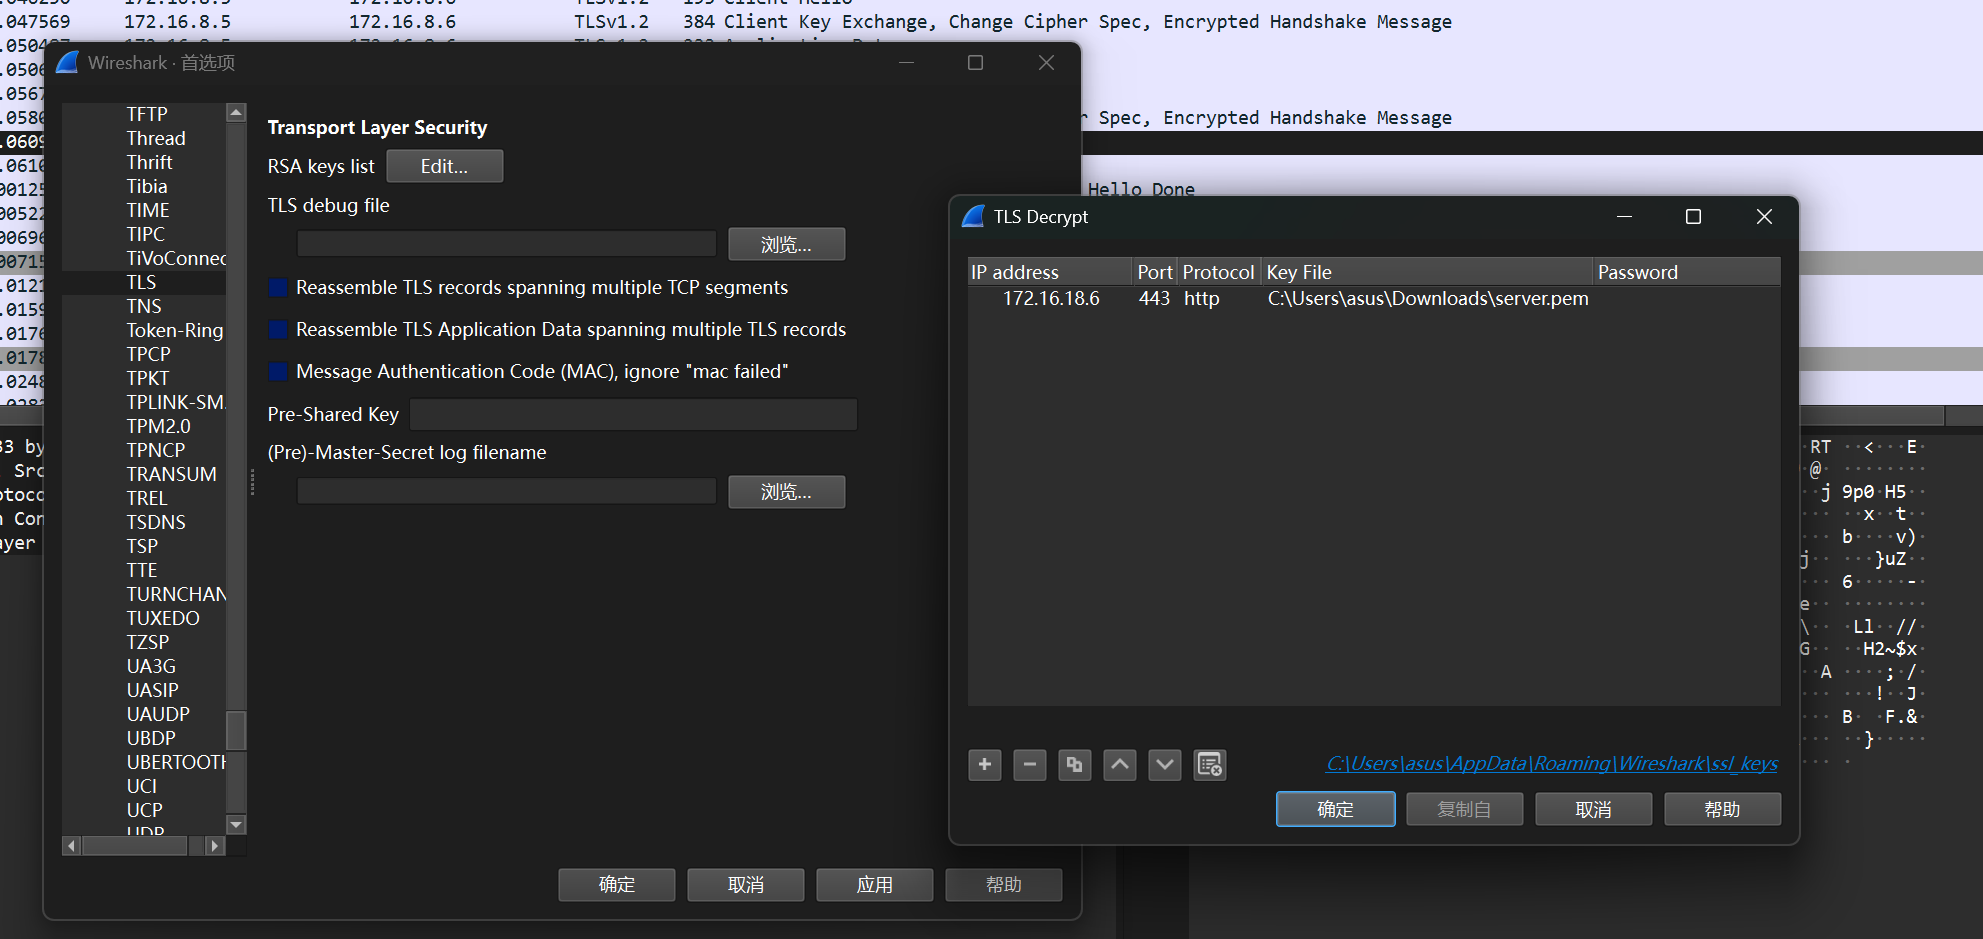
导入tls的rsa的pem文件wireshark就能自动解密了…
可惜都不会用当时
顺着配置一下wireshark
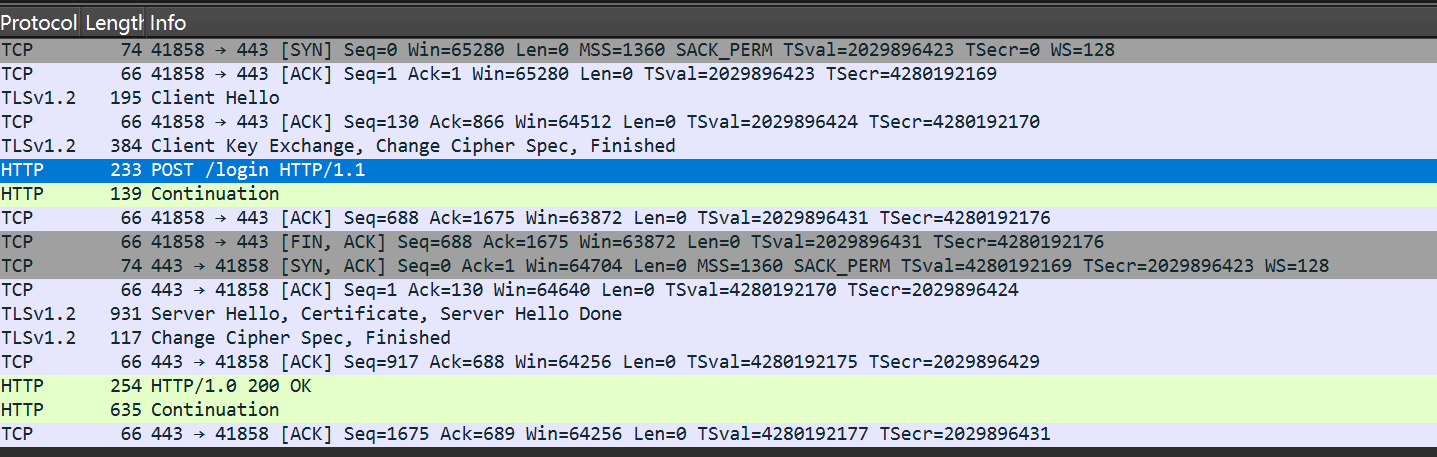
解出来之后能清晰看到登录请求和flag了
可惜可惜
这题拿下基本就国一了,可惜同时考到三个人的知识盲区了
给了给了
3.AES比特翻转攻击
题目
已知使用 AES-128-CBC 对明文: user=xueli&time=202611031125 加密得到的密文是 655acb58e2b9795ba6c8ecb4f81d82b7a411ccd32072e43ec3eccd892a94ead3093ceb45f7c4a08e07b7d7bddde57811(hex 编码)。user=admin&time=202611031125
分析
非常经典的题目啊
用板子(crypto-attacks/attacks/cbc/bit_flipping.py at master · jvdsn/crypto-attacks )一把梭了
exp
def attack (iv, c, pos, p, p_ ): """ Replaces the original plaintext with a new plaintext at a position in the ciphertext. :param iv: the initialization vector :param c: the ciphertext :param pos: the position to modify at :param p: the original plaintext :param p_: the new plaintext :return: a tuple containing the modified initialization vector and the modified ciphertext """ iv_ = bytearray (iv) c_ = bytearray (c) for i in range (len (p)): if pos + i < 16 : iv_[pos + i] = iv[pos + i] ^ p[i] ^ p_[i] else : c_[pos + i - 16 ] = c[pos + i - 16 ] ^ p[i] ^ p_[i] return iv_, c_ raw = bytes .fromhex(hexct) iv, c = raw[:16 ], raw[16 :] iv_, c_ = attack(iv, c, 5 , b"xueli" , b"admin" ) print ((bytes (iv_) + bytes (c_)).hex ())
4.rsa前面伪造
题目
📋 背景 某系统使用 RSA(公钥指数 e = 3 )对登录命令签名。服务端校验:签名解出的消息等于目标登录命令 CMD=LOGIN&USER=Admin&role=admin 的 PKCS 以下为服务端验签源码(明文公开,请仔细分析其漏洞): def verify (signature, n, e, target ): keylen = (n.bit_length() + 7 ) // 8 em = pow (signature, e, n) em_bytes = em.to_bytes(keylen, 'big' ) if em_bytes[:2 ] != b'\x00\x01' : return False asn1 = sha256_der(target) idx = em_bytes.find(b'\x00' + asn1) if idx < 2 : return False return True 📌 参数 n = 0xc0f6c3a5466f87ae18fffa62da425b7620fe9a37ec30a6ff69111a67268e76c3bbfc2b791f5350b18205d73c4a0b2fc27928a22a2516662435649f5cf00f4dd31703779979529fbb64068449424585a03892de77bdc4d6972f10bb7df852d39425048b4b9ada8957078f648e75fb93eb959ae5673707124aeec15428834bdaf288f8186b37bd8e9a288da9dbec912ca743b9156d68f614df09915e2e398fe004d684d1ceffde320f0e7c55c0cd5e572521f7b64e8d09bd0351473b8548894320860846fdf0107eee4918f1d803f33f909014038d93568b58bf58dc88b42a95adae25d39ca6f257f1165b0fb0c38f020c8bb86b93d93d04fb3d8b8abe67cf4627 e = 3 target = CMD=LOGIN&USER=Admin&role=admin target 的 SHA-256 摘要:3031300d06096086480165030402010500042004adac79091c50730eafe973208ee267087b30abacbd5c58abdd77f1f808990d 任务:构造一个能通过上述验签逻辑的伪造签名,提交即可获得 flag (验签通过与否由真实验签代码判定,而非比对某个固定签名值)。 📤 提交伪造签名 输入十六进制伪造签名 s(可含 0x 前缀):
分析
想解这个题目要熟悉PKCS#1 v1.5填充机制
00 | 01 | FF FF FF ... FF | 00 | 30 31 30 0d 06 09 60 86 48 01 65 03 04 02 01 05 00 04 20 || <32字节摘要>
└┬┘ └┬┘  └─────┬──────┘  └┬┘  └────────────────────┬───────────────────────────────┘  └───┬───┘
 0   1       PS(填充)      分隔符              DigestInfo 前缀(19字节)
其中 DigestInfo = 19 字节前缀 + 32 字节摘要 = 51 字节 。
本题验签逻辑:
头两字节是 00 01;存在子串 00‖DigestInfo 且 idx ≥ 2。
这里就有一个问题:PS 段无校验
原本的EM 由摘要唯一确定,没有操作空间,但是此处在PS 能随便填,EM 的结构就可以由我们设计。
验签算的是 s 3 m o d n s^3\,mod \, n s 3 m o d n s 不需要私钥就能算出来。
构造:把 DigestInfo 顶到高位,后面全放垃圾值
EM = 00 01 00 ‖ DigestInfo(51B) ‖ 0x00 × 202 (共 256 字节)
取 s = ⌈∛EM⌉,则 s³ = EM + Δ,其中 Δ < 3s² ≈ 2^1357 ≈ 170 字节。DigestInfo
提交 s 即可
5.非常规数据流的处理
考点范围很广,汗多题目都脱离的传统密码ctf,所以有是碰到什么word或者原始二进制文件加解密会有点茫然
这里梳理一下
1. pem文件
这个重点就是openssl的使用了
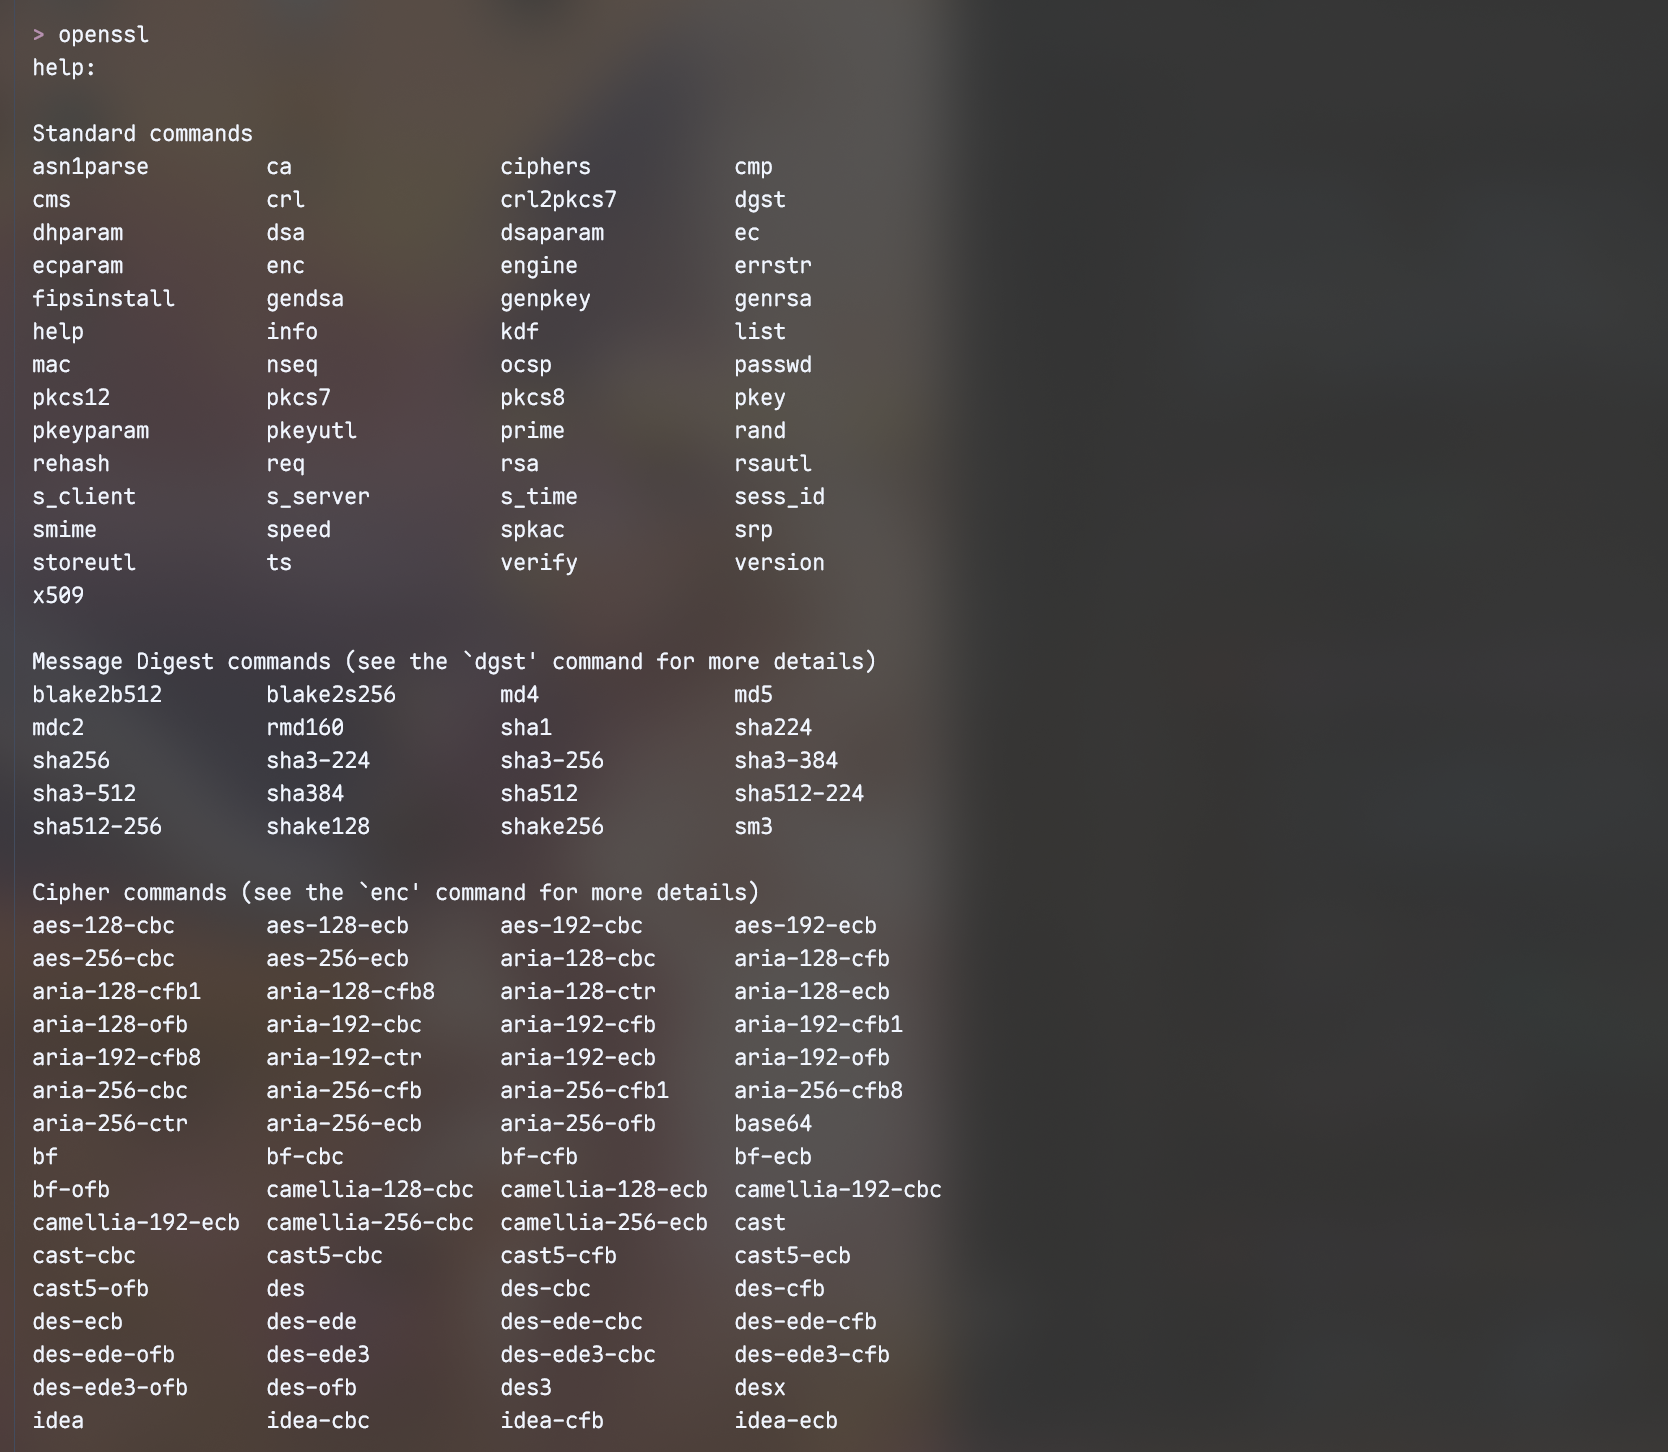
直接输入openssl help你会发现打印出来了命令列表:
这个help的信息在断网情况下对于新手使用者还是很重要的
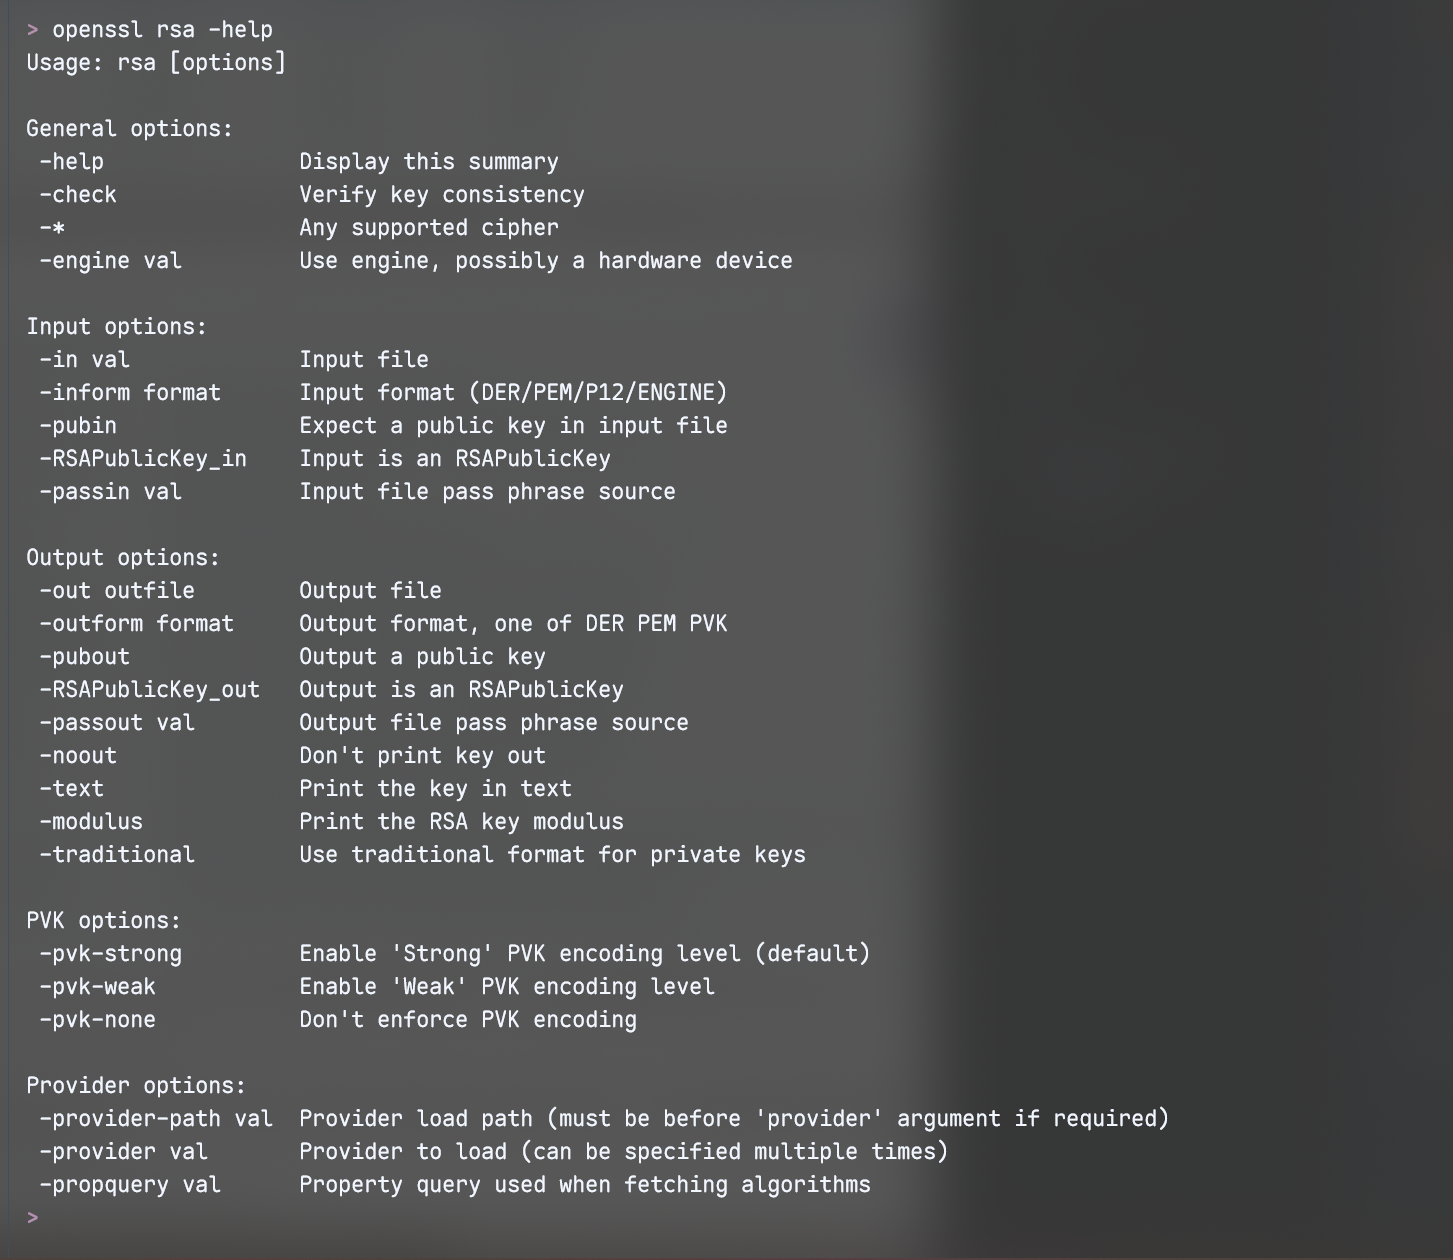
这里的每一项都代表特定的算法或者证书格式,而我们这里涉及的是rsa,所以我们使用openssl rsa -help进一步查看帮助文档
这里列出了和rsa证书有关的项
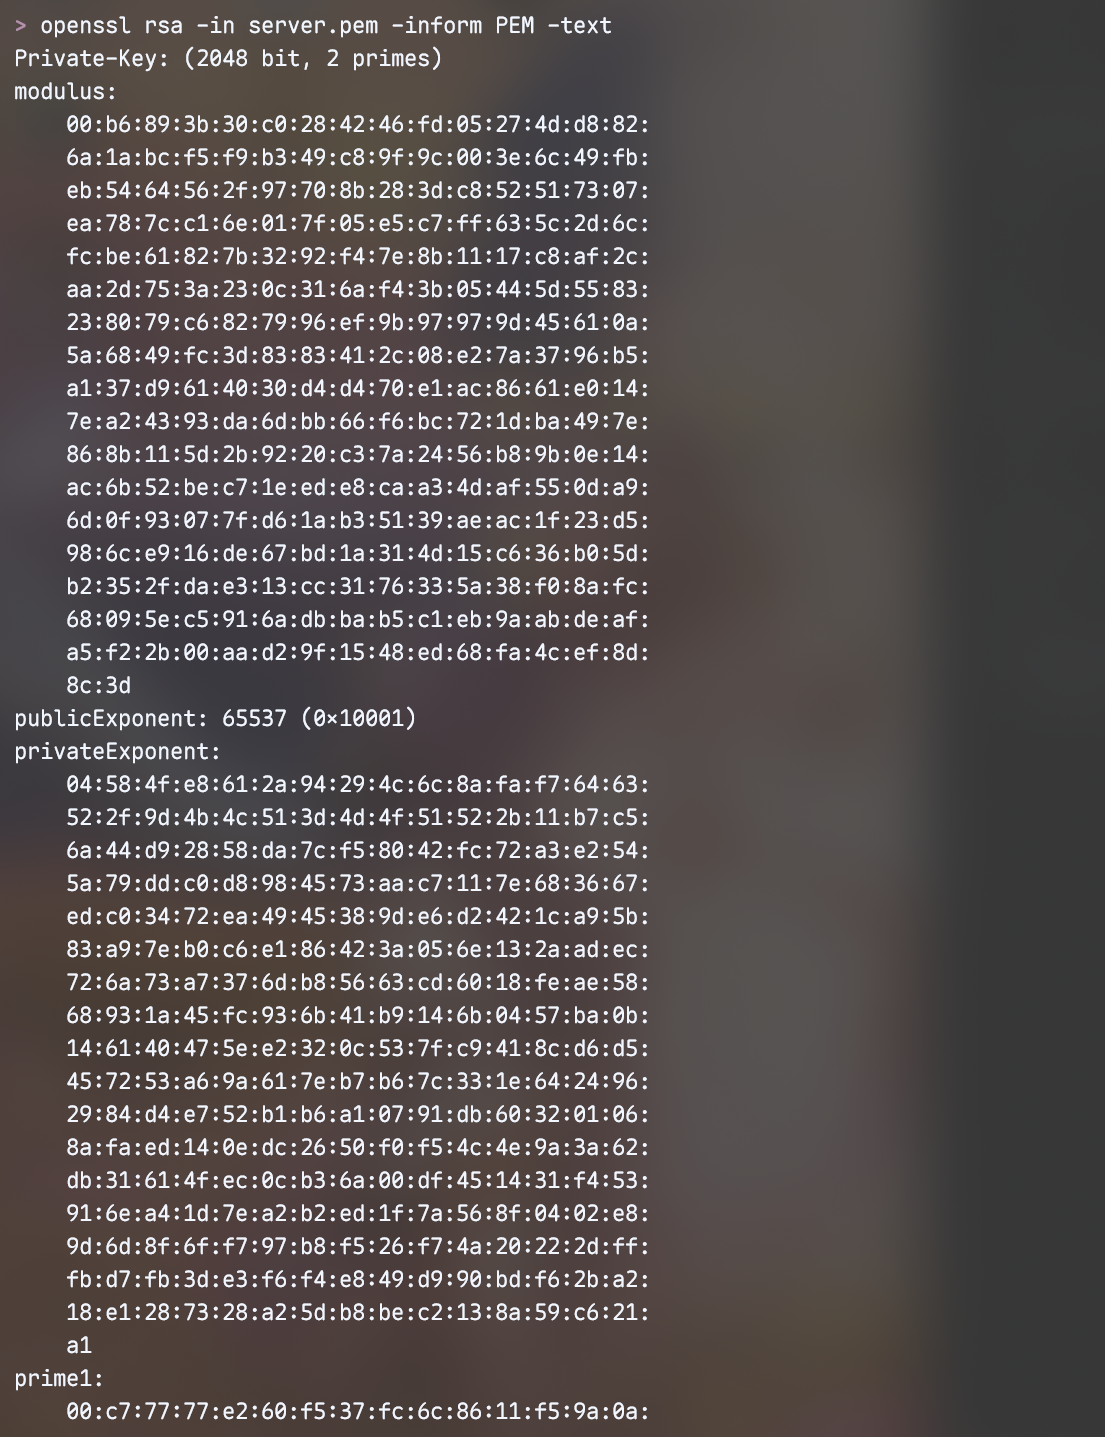
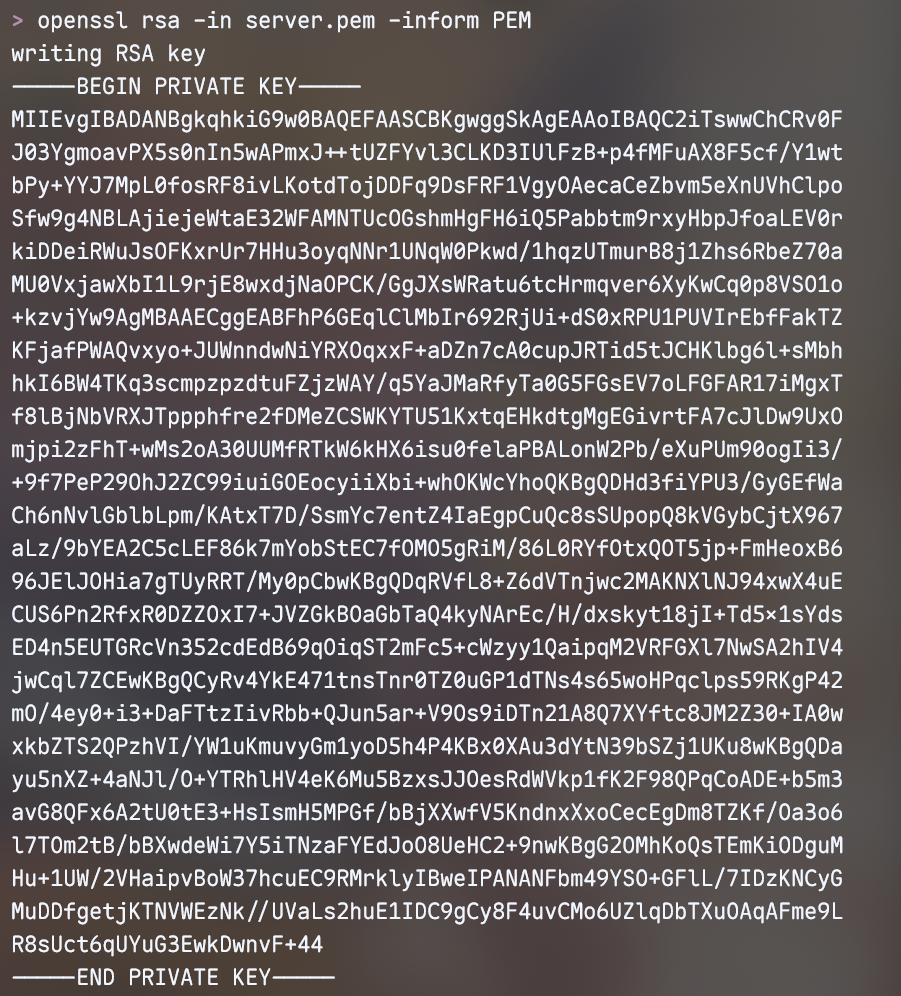
我们要查看密钥内容的话直接
openssl rsa -in key.pem -inform PEM -text
不带-text就是不解析打印一次pem内容:
openssl rsa -in key.pem -inform PEM
2.其他类型
读入python:
b = open (p, 'rb' ).read() for i in range (0 , len (b), 1 << 20 ): chunk = b[i:i + (1 << 20 )] b.find(b'word/document.xml' )
辅助判断的信息:
sniff(b) len (b) entropy(b) printable(b)
某题目exp:
ct = open ('填空2数据.enc' , 'rb' ).read() def step (s ): return s[0 ], s[1 :] + bytes ([s[0 ] ^ s[2 ] ^ s[3 ] ^ s[63 ]]) def back (s ): b = s[63 ] ^ s[1 ] ^ s[2 ] ^ s[62 ] return b, bytes ([b]) + s[:63 ] s = ct[1700 :1764 ] fwd = bytearray () for _ in range (len (ct) - 1700 ): o, s = step(s) fwd.append(o) s = ct[1700 :1764 ] pre = bytearray () for _ in range (1700 ): o, s = back(s) pre.append(o) pre.reverse() pt = bytes (a ^ b for a, b in zip (ct, bytes (pre) + bytes (fwd))) open ('out.docx' , 'wb' ).write(pt)print (pt[:4 ], pt[:4 ] == b'PK\x03\x04' )